

Bu metin, Kotlin Coroutines kitabının bir bölümüdür. Kitabın tamamına LeanPub üzerinden erişebilirsiniz
Bu kitabı, kendi mütevazı "en iyi uygulamalar" listemle sonlandırmak istiyorum. Bu önerilerin tamamı kitap boyunca zaten
tartışıldı; dolayısıyla burayı kısa bir özet olarak da görebilirsiniz. Ancak umuyorum ki bu bölüm, günlük pratiğinizde
bu ilkeleri hatırlamanıza ve uygulamanıza yardımcı olacaktır.
tartışıldı; dolayısıyla burayı kısa bir özet olarak da görebilirsiniz. Ancak umuyorum ki bu bölüm, günlük pratiğinizde
bu ilkeleri hatırlamanıza ve uygulamanıza yardımcı olacaktır.
Eğer bir işlemi
gerçekleştirmiyorsanız, bu yapının asenkron tanımlanmasının bir anlamı yoktur. Bu durumda
async ile başlatıp hemen ardından beklemeye (await) alıyorsanız ve bu sırada hiçbir başka işlemgerçekleştirmiyorsanız, bu yapının asenkron tanımlanmasının bir anlamı yoktur. Bu durumda
async yerine doğrudanwithContext veya sıradan bir suspend fonksiyon kullanmak daha doğru olacaktır.// Yanlış Kullanım – Gereksiz async + immediate await suspend fun getUser(): User = coroutineScope { val user = async { repo.getUser() }.await() // async hemen await ediliyor, asenkronluğun faydası yok user.toUser() } // Doğru Kullanım – Doğrudan çağrı suspend fun getUser(): User { val user = repo.getUser() // Fonksiyon zaten askıya alınabilir, doğrudan çağırmak yeterli return user.toUser() }
Bu dönüşümün her zaman bu kadar basit olmadığı durumlar da vardır. Eğer bir kapsam (scope) tanımlamanız gerekiyorsa,
belirtmeniz gerekiyorsa, bunun için
async { ... }.await() kullanmak yerine coroutineScope tercih edilmelidir. Eğer özel bir bağlam (context)belirtmeniz gerekiyorsa, bunun için
withContext kullanılmalıdır.Eğer birden fazla
okunabilirliği artırmak adına, tüm görevlerde
işlemleri görsel olarak ayırt etmek daha kolay olur.
async görev başlatıyorsanız, genellikle yalnızca sonuncusu await ile beklenir. Ancakokunabilirliği artırmak adına, tüm görevlerde
async kullanmanızı öneririm. Böylece yapının amacını ve paralelişlemleri görsel olarak ayırt etmek daha kolay olur.
fun showNews() {
    viewModelScope.launch {
        // Konfigürasyon verisi ayrı bir coroutine'de alınır
        val config = async { getConfigFromApi() }

        // Haberler, konfigürasyon verisi geldikten sonra alınır
        val news = async { getNewsFromApi(config.await()) }

        // Kullanıcı bilgisi bağımsız olarak alınabilir
        val user = async { getUserFromApi() }
        // Teknik olarak burada async zorunlu değil,
        // ancak tüm veriler aynı yapı içinde async ile alındığında okunabilirlik artar

        // Tüm veriler alındıktan sonra arayüz güncellenir
        view.showNews(user.await(), news.await())
    }
}
Birden fazla
Çünkü
Oysa
olacak bir işlemi gereksiz yere geciktirebilir ve hata yönetimini zorlaştırabilir.
async görevini beklerken map { it.await() } yerine awaitAll fonksiyonu tercih edilmelidir.Çünkü
awaitAll, görevlerden biri istisna (exception) fırlattığında beklemeyi derhal durdurur.Oysa
map { it.await() } her coroutine'i sırayla bekler ve yalnızca hatalı olana ulaşınca durur. Bu durum, başarısızolacak bir işlemi gereksiz yere geciktirebilir ve hata yönetimini zorlaştırabilir.
Askıya alınan bir fonksiyonu (suspending function) çağırdığınızda, mevcut iş parçacığının (thread) engellenmesi (
blocking) gibi bir durumdan endişe duymamalısınız. Bu özellikle, çoğunlukla
platformunda kritik öneme sahiptir; ancak aynı zamanda, eşzamanlama (senkronizasyon) için tek iş parçacığıyla sınırlı
dispatcher’lar kullanılan backend uygulamalarında da önemlidir.
blocking) gibi bir durumdan endişe duymamalısınız. Bu özellikle, çoğunlukla
Dispatchers.Main kullandığımız Androidplatformunda kritik öneme sahiptir; ancak aynı zamanda, eşzamanlama (senkronizasyon) için tek iş parçacığıyla sınırlı
dispatcher’lar kullanılan backend uygulamalarında da önemlidir.
İçinde engelleyici (blocking) işlemler bulunan her askıya alınan fonksiyon, mutlaka
uygun olarak yapılandırılmış özel bir dispatcher kullanmalıdır. Benzer şekilde, işlemci yoğunluklu (CPU-intensive)
işlemler gerçekleştiren fonksiyonlar ise
belirtilmek yerine, fonksiyonun içinde
dispatcher belirleme sorumluluğundan kurtulur ve her iş parçacığından güvenli, tekrar kullanılabilir hâle gelir.
Dispatchers.IO ya da engellenmeyeuygun olarak yapılandırılmış özel bir dispatcher kullanmalıdır. Benzer şekilde, işlemci yoğunluklu (CPU-intensive)
işlemler gerçekleştiren fonksiyonlar ise
Dispatchers.Default veya paralelliği sınırlanmış (Dispatchers.Default.limitedParallelism(...)) dispatcher kullanmalıdır. Dispatcher’lar fonksiyon çağrılarında doğrudanbelirtilmek yerine, fonksiyonun içinde
withContext yapısı kullanılarak atanmalıdır. Böylece fonksiyon çağrıları,dispatcher belirleme sorumluluğundan kurtulur ve her iş parçacığından güvenli, tekrar kullanılabilir hâle gelir.
class DiscSaveRepository(
    private val discReader: DiscReader // Diskten veri okumak için kullanılan bağımlılık
) : SaveRepository {

    override suspend fun loadSave(name: String): SaveData =
        withContext(Dispatchers.IO) { // Disk işlemleri için uygun dispatcher atanır
            discReader.read("save/$name") // Diskten veriyi okuyan (engelleyici) işlem
        }
}
Flow döndüren fonksiyonlar, işlemlerin çalışacağı dispatcher’ı belirlemek için flowOn kullanmalıdır.flowOn, tanımlandığı konumun üstündeki tüm işlemlerin bağlamını (context) değiştirir; bu nedenle fonksiyon içindegenellikle en son aşamada kullanılır.
Android görünümünü (view) güncelleyen askıya alınan fonksiyonlarda (
dispatcher’ının açıkça belirtilip belirtilmemesi tartışmalı bir konudur. Bu noktadaki kararınız, projenizin genel
ilkelerine bağlıdır.
Örneğin, birçok Android projesinde sunum katmanı (presentation layer) gibi
dispatcher kabul edildiği katmanlarda bunu açıkça belirtmeye gerek yoktur.
suspending functions) Dispatchers.Main.immediatedispatcher’ının açıkça belirtilip belirtilmemesi tartışmalı bir konudur. Bu noktadaki kararınız, projenizin genel
ilkelerine bağlıdır.
Örneğin, birçok Android projesinde sunum katmanı (presentation layer) gibi
Dispatchers.Main'in zaten varsayılandispatcher kabul edildiği katmanlarda bunu açıkça belirtmeye gerek yoktur.
Bu sınıflar için birim testi (unit test) yazmak istiyorsanız, dispatcher'ı dışarıdan enjekte etmeniz gerektiğini
unutmayın. Böylece testlerde dispatcher’ı değiştirme ve uygun test ortamı oluşturma imkânınız olur.
unutmayın. Böylece testlerde dispatcher’ı değiştirme ve uygun test ortamı oluşturma imkânınız olur.
class DiscSaveRepository(
    private val discReader: DiscReader,                       // Diskten veri okumak için kullanılan bağımlılık
    private val dispatcher: CoroutineContext = Dispatchers.IO  // Birim testlerinde değiştirilebilir dispatcher
) : SaveRepository {

    override suspend fun loadSave(name: String): SaveData =
        withContext(dispatcher) {                              // Dispatcher dışarıdan belirlenebilir
            discReader.read("save/$name")                      // Engelleyici (blocking) disk işlemi
        }
}
Dispatchers.Main.immediate, gereksiz yere coroutine yeniden yönlendirmelerinden (redispatching) kaçınan,Dispatchers.Main dispatcher’ının optimize edilmiş bir sürümüdür. Genel olarak bunu tercih etmeliyiz.suspend fun showUser(user: User) = withContext(Dispatchers.Main.immediate) { userNameElement.text = user.name // Diğer UI güncelleme işlemleri burada yapılabilir }
İşlemciyi yoğun kullanan (CPU-intensive), engelleyici (blocking) ya da uzun süren işlemler içeren askıya alınan
fonksiyonlarda (
fonksiyonlarda (
suspend fonksiyonlar), işlem blokları arasına yield eklemek iyi bir uygulamadır.yield fonksiyonu, coroutine’i kısa süreliğine askıya alıp (suspend) hemen ardından tekrar devam ettirir. Bumekanizma sayesinde coroutine, gerektiğinde iptal edilmeyi (cancellation) destekler hâle gelir. Ayrıca
yieldçağrımı, coroutine’in iş parçacığını (thread) tekrar planlamasına (redispatch) olanak tanır. Böylece yoğun işlemler
gerçekleştiren bir coroutine, diğer coroutine’lerin çalışmasını engellemez.
// CPU yoğun işlemler arasında yield() kullanımı örneği
suspend fun cpuIntensiveOperations() =
    withContext(Dispatchers.Default) {
        cpuIntensiveOperation1()
        yield() // Diğer coroutine'lere çalışma fırsatı verir, iptal edilmeyi kolaylaştırır
        cpuIntensiveOperation2()
        yield()
        cpuIntensiveOperation3()
    }

// Engelleyici (blocking) işlemler arasında yield() kullanımı örneği
suspend fun blockingOperations() =
    withContext(Dispatchers.IO) {
        blockingOperation1()
        yield() // Coroutine yeniden planlanır (redispatch), iptale izin verilir
        blockingOperation2()
        yield()
        blockingOperation3()
    }
Coroutine yapılandırıcıları (coroutine builders) içinde
coroutine'in aktif olduğundan emin olmak için kontrol yapar ve eğer coroutine iptal edilmişse bir
ensureActive fonksiyonu da kullanılabilir. Bu fonksiyon,coroutine'in aktif olduğundan emin olmak için kontrol yapar ve eğer coroutine iptal edilmişse bir
CancellationException fırlatır. Bu, coroutine'in iptal durumunu düzgün şekilde ele almanızı sağlar.Bir ana coroutine, çocuk coroutine'leri tamamlamadan önce sona eremez.
coroutine kapsamı fonksiyonları, alt coroutine'lerinin tamamlanmasını beklemek için ana coroutine'i askıya alır. Bu
nedenle, başlatılan tüm coroutine'lerin tamamlanmasını beklerler. Sonuç olarak, bir
çocuk coroutine'lerini tamamlayana kadar sonlanmaz.
coroutineScope veya withContext gibicoroutine kapsamı fonksiyonları, alt coroutine'lerinin tamamlanmasını beklemek için ana coroutine'i askıya alır. Bu
nedenle, başlatılan tüm coroutine'lerin tamamlanmasını beklerler. Sonuç olarak, bir
suspend fonksiyonu, başlattığı tümçocuk coroutine'lerini tamamlayana kadar sonlanmaz.
import kotlinx.coroutines.*

//sampleStart
suspend fun longTask() = coroutineScope {
    // İlk launch coroutine'i, 1 saniye bekler ve ardından çıktıyı yazdırır
    launch {
        delay(1000)
        println("Done 1")
    }

    // İkinci launch coroutine'i, 2 saniye bekler ve ardından çıktıyı yazdırır
    launch {
        delay(2000)
        println("Done 2")
    }
}

suspend fun main() {
    println("Before") // Başlangıç çıktısı
    longTask() // longTask fonksiyonu çağrılır ve iki coroutine başlatılır
    println("After") // Sonrasındaki çıktıyı yazdırır
}
// Çıktı:
// Before
// (1 saniye bekleme)
// Done 1
// (1 saniye daha bekleme)
// Done 2
// After
//sampleEnd
Bir coroutine scope (eşzamanlı işlem birimi kapsamı) fonksiyonunu
unutmayın; çünkü onu silersek hiçbir şey değişmeyecektir.
launch ifadesiyle bitirmenin bir anlamı olmadığınıunutmayın; çünkü onu silersek hiçbir şey değişmeyecektir.
suspend fun updateUser() = coroutineScope {
    // ...

    // Yapmayın
    launch { sendEvent(UserSunchronized) }
}
Askıya alınabilir (suspending) fonksiyonların, başlattıkları coroutine'lerin tamamlanmasını beklemelerini bekleriz. Bu
beklenti, harici bir scope (kapsam) kullanılarak aşılabilir; ancak geçerli bir neden olmadıkça bunu yapmaktan
kaçınmalıyız.
beklenti, harici bir scope (kapsam) kullanılarak aşılabilir; ancak geçerli bir neden olmadıkça bunu yapmaktan
kaçınmalıyız.
suspend fun updateUser() = coroutineScope {
    // ...

    // Harici bir scope kullanımı — dikkatli olunmalı
    eventsScope.launch { sendEvent(UserSunchronized) }
}
Kotlin Coroutines kullanan projelerde en çok hata yapılmasına neden olan yanlış anlamalardan biri,
context) miras alınan tek bağlam olmamasıdır. Diğer bağlamlar alt coroutine’lere aktarılırken,
yerine, bir üst coroutine'den ya da argümandan gelen
Job bağlamının (context) miras alınan tek bağlam olmamasıdır. Diğer bağlamlar alt coroutine’lere aktarılırken,
Job aktarılmaz. Bununyerine, bir üst coroutine'den ya da argümandan gelen
Job, başlatılan coroutine’in üstü (parent) olarak kullanılır.Bazı örneklere bakalım. Bir coroutine oluşturucuya (
bu hiçbir şeyi değiştirmez.
launch, async gibi) SupervisorJob eklemek anlamsızdır; çünkübu hiçbir şeyi değiştirmez.
// Yapmayın
fun main(): Unit = runBlocking(SupervisorJob()) {
        launch {
            delay(1000)
            throw Error()
        }
        launch {
            delay(2000)
            println("Done")
        }
        launch {
            delay(3000)
            println("Done")
        }
    }
// (1 saniye sonra)
// Hata (Error)...
Job, miras alınmayan tek bağlam (context) türüdür. Her coroutine'in kendi Job nesnesine ihtiyacı vardır ve bircoroutine’e
Job geçirilmesi, bu geçirilen Job'un ilgili coroutine'in üstü (parent) olmasına neden olur.Yukarıdaki örnekte,
SupervisorJob, runBlocking coroutine’inin üstü konumundadır. Bir alt coroutine’de (child) biristisna (exception) oluştuğunda, bu istisna
runBlocking coroutine’ine iletilir, onun Job'u bozulur (break), altcoroutine’ler iptal edilir ve istisna fırlatılır.
SupervisorJob öğesinin üst konumda olması ise pratikte hiçbir etkiyaratmaz.
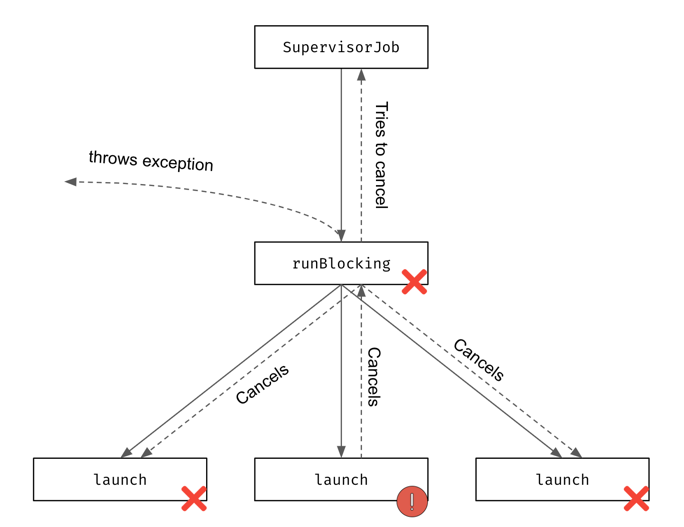
Benzer bir hatayla,
withContext ifadesi SupervisorJob ile birlikte kullanıldığında çok daha sık karşılaşıyorum.// Yapmayın suspend fun sendNotifications( notifications: List<Notification> ) = withContext(SupervisorJob()) { for (notification in notifications) { launch { client.send(notification) } } }
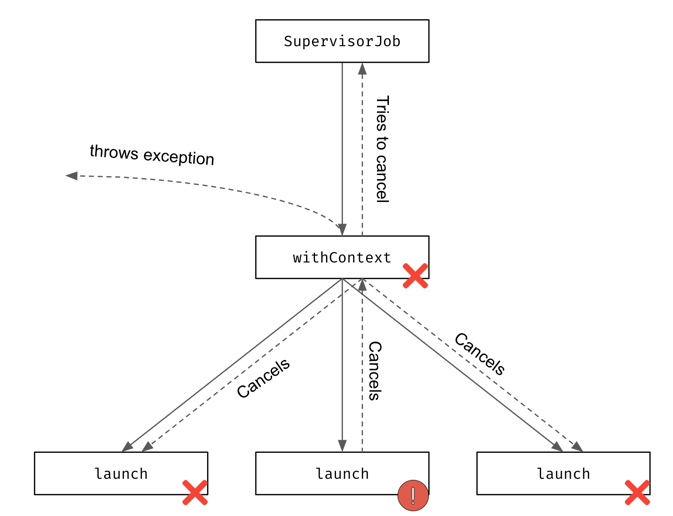
SupervisorJob'u bu şekilde kullanmak anlamsızdır. Bu tür bir kullanım gördüğümde, genellikle amacın altcoroutine'lerdeki istisnaları (exceptions) bastırmak olduğunu tahmin edebiliyorum. Ancak bunu yapmanın doğru yolu
supervisorScope kullanmaktır; çünkü supervisorScope, doğrudan alt coroutine'lerinde oluşan istisnaları yok sayar.// Doğru kullanım suspend fun sendNotifications( notifications: List<Notification> ) = supervisorScope { for (notification in notifications) { launch { client.send(notification) } } }
withContext(Job()) kullanımı anlamsızdır ve aynı zamanda bir hata olarak değerlendirilmelidir.Yukarıda sunduğumuz hatalar yalnızca anlamsız değil, aynı zamanda zararlıdır. Coroutine bağlamına (context) açıkça bir
atın.
atanmasıdır. Sonuç olarak,
çağıran coroutine iptal edilse bile, bizim coroutine iptal edilmez ve içindeki işlemler çalışmaya devam ederek kaynak
israfına neden olur.
Job tanımladığınız her durumda, bu coroutine’in üstü (parent) ile olan ilişkiyi koparırsınız. Aşağıdaki örneğe gözatın.
Job öğesinin coroutine’e argüman olarak verilmesindeki problem, bu Job'un ilgili coroutine’in üstü olarakatanmasıdır. Sonuç olarak,
withContext fonksiyonu bu fonksiyonu çağıran coroutine’in çocuğu (child) olmaz. Bu nedenle,çağıran coroutine iptal edilse bile, bizim coroutine iptal edilmez ve içindeki işlemler çalışmaya devam ederek kaynak
israfına neden olur.
Harici bir
bunun sonucunda bellek sızıntılarına (memory leaks) yol açar.
Job ya da scope (kapsam) kullanmak, yapısal eşzamanlılığı bozar, düzgün iptal mekanizmasını engeller vebunun sonucunda bellek sızıntılarına (memory leaks) yol açar.
// Yapmayın
suspend fun getPosts() = withContext(Job()) {
        val user = async { userService.currentUser() }
        val posts = async { postsService.getAll() }
        posts.await()
            .filterCanSee(user.await())
    }
Bir scope (kapsam) oluşturduğumuzda, bu scope ile başlatılan coroutine’lerden birinde meydana gelen bir istisnanın (
exception), diğer tüm coroutine’leri iptal etmesini istemediğimizi varsayabiliriz. Bu davranışı sağlamak için,
varsayılan olarak kullanılan
exception), diğer tüm coroutine’leri iptal etmesini istemediğimizi varsayabiliriz. Bu davranışı sağlamak için,
varsayılan olarak kullanılan
Job yerine SupervisorJob kullanmamız gerekir.// Yanlış kullanım val scope = CoroutineScope(Job()) // Doğru kullanim val scope = CoroutineScope(SupervisorJob())
Bir scope iptal edildikten sonra yeniden kullanılamaz. Eğer bir scope üzerinde başlatılan tüm görevleri (tasks) iptal
etmek istiyorsanız ancak scope’un kendisini aktif tutmak istiyorsanız, scope’un çocuklarını (children) iptal edin. Bir
scope’u aktif tutmak herhangi bir maliyet oluşturmaz.
etmek istiyorsanız ancak scope’un kendisini aktif tutmak istiyorsanız, scope’un çocuklarını (children) iptal edin. Bir
scope’u aktif tutmak herhangi bir maliyet oluşturmaz.
fun onCleared() {
    // Bunu yapmayı düşünün
    scope.coroutineContext.cancelChildren()

    // Bunun yerine
    scope.cancel()
}
Android platformunda, özel scope’lar tanımlayıp iptal etmek yerine,
kütüphanelerinden gelen yaşam döngüsü (lifecycle) farkındalığına sahip coroutine scope’larını kullanmalısınız; çünkü bu
scope’lar otomatik olarak iptal edilir.
viewModelScope, lifecycleScope ve KTXkütüphanelerinden gelen yaşam döngüsü (lifecycle) farkındalığına sahip coroutine scope’larını kullanmalısınız; çünkü bu
scope’lar otomatik olarak iptal edilir.
Android üzerinde Kotlin Coroutines kullanırken en sevdiğim sezgisel kural şudur: "Hangi scope’u kullanacağını seçmek, bu
coroutine’in ne zaman iptal edilmesini istediğini seçmektir." Her
ve bu scope, ilgili ViewModel sonlandığında iptal edilir. Her
ve bu da ilgili yaşam döngüsü tamamlandığında iptal edilir.
coroutine’in ne zaman iptal edilmesini istediğini seçmektir." Her
ViewModel, kendisine ait bir viewModelScope sağlarve bu scope, ilgili ViewModel sonlandığında iptal edilir. Her
LifecycleOwner, kendine ait bir lifecycleScope içerirve bu da ilgili yaşam döngüsü tamamlandığında iptal edilir.
Bu scope’ları, paylaşılan küresel (global) scope’lar yerine kullanmamızın nedeni, coroutine’lerin artık gerekli
olmadıklarında iptal edilmelerini istememizdir. Bir coroutine’i farklı bir scope üzerinde başlatmak, onun başka
koşullarda iptal edileceği anlamına gelir.
olmadıklarında iptal edilmelerini istememizdir. Bir coroutine’i farklı bir scope üzerinde başlatmak, onun başka
koşullarda iptal edileceği anlamına gelir.
GlobalScope üzerinde başlatılan coroutine’ler ise asla iptal edilmez.class MainViewModel : ViewModel() { val scope = CoroutineScope(SupervisorJob()) fun onCreate() { viewModelScope.launch { // MainViewModel ile birlikte iptal edilir launch { task1() } // Asla iptal edilmez GlobalScope.launch { task2() } // scope iptal edildiğinde iptal edilir scope.launch { task2() } } } }
GlobalScope kullanmak çok kolaydır ve bu yüzden cazip görünebilir; ancak bunu kullanmaktan kaçınmanızı öneririm. Bununyerine, en azından yalnızca
SupervisorJob içeren basit bir scope oluşturmanız daha güvenlidir.val scope = CoroutineScope(SupervisorJob()) fun example() { // Yapmayın — GlobalScope ile başlatılan coroutine asla iptal edilmez GlobalScope.launch { task() } // Doğru kullanım — SupervisorJob ile tanımlanmış scope içinde başlatılır ve gerektiğinde iptal edilebilir scope.launch { task() } }
GlobalScope, hiçbir ilişki (parent-child ilişkisi) olmadığı, iptal mekanizmasının bulunmadığı ve test sırasındaüzerine yazılması(override) zor olan bir yapıdır. Şu an için sadece
GlobalScope yeterli gibi görünse bile, anlamlı birscope
tanımlamak gelecekte faydalı olabilir.
// GlobalScope tanımı
public object GlobalScope : CoroutineScope {
    override val coroutineContext: CoroutineContext
        get() = EmptyCoroutineContext
}
Job fonksiyonu aracılığıyla bir iş (job) nesnesi oluşturduğunuzda, bu nesne çocuklarının (child coroutines) durumundanbağımsız olarak etkin (active) durumda başlatılır. Bazı alt coroutine’ler tamamlanmış olsa dahi, bu durum ebeveyn
coroutine’in de tamamlandığını göstermez.
import kotlinx.coroutines.*

//sampleStart
suspend fun main(): Unit = coroutineScope {
    val job = Job()

    // job ile ilişkilendirilmiş ilk coroutine
    launch(job) {
        delay(1000)
        println("Text 1")
    }

    // job ile ilişkilendirilmiş ikinci coroutine
    launch(job) {
        delay(2000)
        println("Text 2")
    }

    job.join() // Bu noktada sonsuza dek beklenir çünkü job hiçbir zaman tamamlanmış sayılmaz
    println("Will not be printed") // Bu satır asla çalıştırılmaz
}
// (1. saniye)
// Text 1
// (1. saniye sonra)
// Text 2
// (uygulama sonsuza dek çalışır)
//sampleEnd
Böyle bir
durumu "Active" (etkin) hâlinden "Completing" (tamamlanıyor) hâline geçirildiğinde gerçekleşir. Bu aşamada
coroutine’lerin tamamlanmasını bekler. Ancak, tamamlanmakta olan (completing) veya tamamlanmış (completed) bir
üzerinde yeni coroutine başlatılamaz.
Job nesnesinin tamamlanması mümkündür, ancak bu yalnızca önce complete yöntemi çağrıldığında ve ardındandurumu "Active" (etkin) hâlinden "Completing" (tamamlanıyor) hâline geçirildiğinde gerçekleşir. Bu aşamada
Job, çocukcoroutine’lerin tamamlanmasını bekler. Ancak, tamamlanmakta olan (completing) veya tamamlanmış (completed) bir
Jobüzerinde yeni coroutine başlatılamaz.
Daha uygulanabilir bir yaklaşım, çocuk coroutine’leri beklemek için ilgili
döndürülen
saklanması ya da başlatılan tüm coroutine’lerin
Job nesnesinin referansını kullanmaktır (job.children.forEach { it.join() }). Bununla birlikte, çoğu durumda en yalın çözüm, coroutine oluşturucu tarafındandöndürülen
Job nesnesini beklemektir (join). Yaygın senaryolar arasında etkin görev Job'unun bir değişkendesaklanması ya da başlatılan tüm coroutine’lerin
Job nesnelerinin toplanması yer alır.class SomeService { private var job: Job? = null private val scope = CoroutineScope(SupervisorJob()) // Her yeni görev başlatıldığında, // önceki görev iptal edilir. fun startTask() { cancelTask() job = scope.launch { // ... } } fun cancelTask() { job?.cancel() } }
class SomeService {
    private var jobs: List<Job> = emptyList()
    private val scope = CoroutineScope(SupervisorJob())

    fun startTask() {
        // Yeni bir görev başlatılır ve mevcut job listesine eklenir
        jobs += scope.launch {
            // ...
        }
    }

    fun cancelTask() {
        // Tüm aktif job'lar iptal edilir
        jobs.forEach { it.cancel() }
    }
}
Genel önerim, bir scope oluşturmak dışında
Job oluşturucusunun (Job builder) kullanımından kaçınılması yönündedir.Bir
işlemleri tanımlar ve yürütmeleri, söz konusu işlemlerin gerçekten başlatıldığı ana kadar ertelenir. Bu durum, doğrudan
işlemi gerçekleştirmesi beklenen askıya alınabilir (suspending) fonksiyonlardan oldukça farklıdır. Bu iki kavramı
karıştırmak sezgisel değildir ve uygulamada sorunlara yol açabilir. Örneğin, gözlemlenecek servisleri alan ve ardından
bu servisleri gözlemleyen bir fonksiyona ihtiyaç duyduğunuzu varsayalım. Aşağıdaki uygulama bu açıdan sorunludur:
Flow, collect fonksiyonu ile başlatılan belirli bir işlemi temsil eder. Flow döndüren fonksiyonlar bu türişlemleri tanımlar ve yürütmeleri, söz konusu işlemlerin gerçekten başlatıldığı ana kadar ertelenir. Bu durum, doğrudan
işlemi gerçekleştirmesi beklenen askıya alınabilir (suspending) fonksiyonlardan oldukça farklıdır. Bu iki kavramı
karıştırmak sezgisel değildir ve uygulamada sorunlara yol açabilir. Örneğin, gözlemlenecek servisleri alan ve ardından
bu servisleri gözlemleyen bir fonksiyona ihtiyaç duyduğunuzu varsayalım. Aşağıdaki uygulama bu açıdan sorunludur:
// Askıya alınabilir (suspending) fonksiyon ile Flow döndürmeyin — önerilmez
suspend fun observeNewsServices(): Flow<News> {
    val newsServices = fetchNewsServices()
    return newsServices
        .asFlow()
        .flatMapMerge { it.observe() }
}

suspend fun main() {
    val flow = observeNewsServices() // Servisler burada getirilir
    // ...
    flow.collect { println(it) } // Gözlemleme burada başlatılır
}
İşlemin bir bölümünün
yürütülmesi sezgilere aykırıdır. Ayrıca, eğer
haber öğeleri kullanılmaya devam edilir. Bu durum hem sorunludur hem de sezgisel olarak beklenen davranışla çelişir.
Beklentimiz,
observeNewsServices fonksiyonu çağrıldığında, bir bölümünün ise collect işlemi başladığındayürütülmesi sezgilere aykırıdır. Ayrıca, eğer
collect işlemi daha sonra başlatılırsa, geçmişte alınmış (fetch edilmiş)haber öğeleri kullanılmaya devam edilir. Bu durum hem sorunludur hem de sezgisel olarak beklenen davranışla çelişir.
Beklentimiz,
Flow döndüren fonksiyonların tüm süreci bu Flow yapısının içerisine dahil etmesidir.Yukarıdaki fonksiyonun daha doğru ve tutarlı bir şekilde yapılandırılması için en yaygın yaklaşım, askıya alınabilir (
suspend) çağrıların flow bloğu içerisine yerleştirilmesidir.fun observeNewsServices(): Flow<News> { return flow { // Askıya alınabilir işlem flow bloğu içinde yürütülür emitAll(fetchNewsServices().asFlow()) }.flatMapMerge { // Her bir servis için gözlemleme başlatılır it.observe() } } suspend fun main() { val flow = observeNewsServices() // ... flow.collect { println(it) } // Servislerin alınması (fetching) burada başlar // Gözlemleme (observing) işlemi yine burada başlar }
Alternatif olarak, her zaman olduğu gibi, sürecin tamamlanmasını bekleyen bir askıya alınabilir (suspending) fonksiyon
tanımlanabilir.
tanımlanabilir.
suspend fun fetchNewsFromServices(): List<News> {
    return fetchNewsServices()
        .mapAsync { it.observe() }
        .flatten()
}

suspend fun main() {
    val news = fetchNewsFromServices()
    // Servislerin alınması (fetching)
    // Gözlemlemenin başlatılması (observing)
    // ...
}
Bu derlemeyi en tartışmalı öneriyle sonlandırıyorum. Aşağıdaki fonksiyonu düşünün. Sizce bu
yaymalıdır?
Flow ne tür değerleryaymalıdır?
interface UserRepository {
    fun getUser(): Flow<User>
}
Ben, bu fonksiyonun yalnızca mevcut kullanıcıyı değil, kullanıcı her değiştiğinde yeni bir kullanıcı nesnesi yaymasını
beklerdim. Bunun nedeni,
üretmesi beklenen yapılar için
temsil etmenin doğru yolu askıya alınabilir (
beklerdim. Bunun nedeni,
Flow türünün birden fazla değerin kaynağını temsil etmesidir. Zaman içinde birden fazla değerüretmesi beklenen yapılar için
Flow uygundur. Ancak yalnızca ertelenmiş (deferred) tek bir değer söz konusuysa, bunutemsil etmenin doğru yolu askıya alınabilir (
suspending) fonksiyonlar kullanmaktır.interface UserRepository { suspend fun getUser(): User }
Bu kurala rağmen, özellikle Android uygulamaları olmak üzere birçok uygulama, mümkün olan her yerde askıya alınabilir (
daha önce RxJava kullanmıştır ve alışkanlıklarını değiştirmek istememektedir. Bir arkadaşımın söylediği gibi: "Ben bir
RxJava senior’ıyım ama Kotlin Coroutines konusunda junior’ım. Junior olmayı sevmem, ama Flow RxJava’ya benziyor, belki
Flow konusunda ortalama seviyedeyim."
suspending) fonksiyonlar yerine Flow kullanmaktadır. Bu tercihin arkasındaki nedenleri anlayabiliyorum: bazı ekiplerdaha önce RxJava kullanmıştır ve alışkanlıklarını değiştirmek istememektedir. Bir arkadaşımın söylediği gibi: "Ben bir
RxJava senior’ıyım ama Kotlin Coroutines konusunda junior’ım. Junior olmayı sevmem, ama Flow RxJava’ya benziyor, belki
Flow konusunda ortalama seviyedeyim."
Android tarafında geliştiricilerin bir gerekçesi daha var. Değişken durumları (
Bu nedenle,
mutable state) temsil etmek içinStateFlow kullanmak oldukça yaygınlaştı ve Flow, stateIn fonksiyonu ile kolayca StateFlow’a dönüştürülebiliyor.Bu nedenle,
Flow üzerinde çalışmak pratik bir çözüm sunuyor.class LocationsViewModel( locationService: LocationService ) : ViewModel() { // Lokasyon akışı ViewModel scope'u içinde StateFlow'a dönüştürülüyor private val location = locationService.observeLocations() .map { it.toLocationsDisplay() } // Veriler görsel modele dönüştürülüyor .stateIn( scope = viewModelScope, // Yaşam döngüsüne duyarlı coroutine scope started = SharingStarted.Lazily, // Talep gelene kadar başlamaz // Yaygın bir başka seçenek: // started = SharingStarted.WhileSubscribed(5_000), initialValue = LocationsDisplay.Loading, // Başlangıç değeri ) // ... }
Eğer her yerde
özgü bir tarzı ve uygulama biçimi vardır. Ancak seçim şansı size aitse — belki sıfırdan bir proje tasarlıyorsunuzdur ya
da projeye yeni
kullanmamanızı öneririm. Bu yaklaşım, kodunuzu daha sade, anlaşılır ve verimli hâle getirecektir.
Flow kullanan bir ekibe katılırsanız, en doğrusu ekip alışkanlıklarına uymaktır. Her ekibin kendineözgü bir tarzı ve uygulama biçimi vardır. Ancak seçim şansı size aitse — belki sıfırdan bir proje tasarlıyorsunuzdur ya
da projeye yeni
coroutines dahil etmişsinizdir — bu durumda yalnızca tek bir değer beklediğiniz yerlerde Flowkullanmamanızı öneririm. Bu yaklaşım, kodunuzu daha sade, anlaşılır ve verimli hâle getirecektir.
Bu bölümü kapatmadan önce şunu aklınızda tutmanızı isterim: En iyi uygulamalar (best practices), bazen ihlal edilmeyi
gerektirir; çünkü onlar her duruma değil, standart durumlara yönelik kılavuzlardır.
gerektirir; çünkü onlar her duruma değil, standart durumlara yönelik kılavuzlardır.

